TRIAGE:替 agent 的每個動作『按角色分功過』,改進代理式強化學習
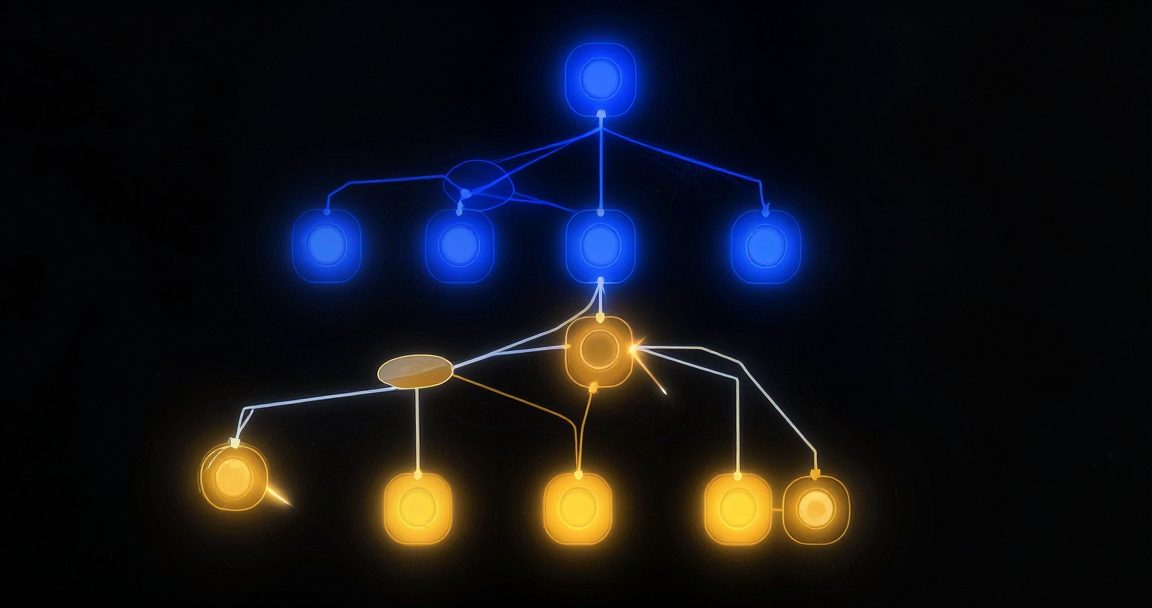
讓 AI agent 靠強化學習變強,有個很實際的難題:一條任務軌跡裡有搜尋、點擊、編輯、導航、跟物件互動等一大堆面向環境的動作,最後成功或失敗的功過,到底該算在哪個動作頭上?標準的 GRPO 做法是拿最終驗證結果,對所有動作 token 給一個一致的優勢值——不管你這步是關鍵決策還是無關緊要的中間操作,通通吃同一份獎懲。這個訊號有用,但太粗。
TRIAGE 這篇論文提出更細緻的做法:依動作的『角色』分型來分配信用。不同種類的動作在任務裡扮演的份量本來就不同,把它們一視同仁地灌同一個優勢值,會讓學習訊號變糊、效率變差。按角色區分後,關鍵動作能拿到更貼切的獎勵、雜訊動作不被過度強化,agent 學起來就更有方向感。說白了,就是把『整組一起賞罰』改成『看你在這局扮什麼角色、各自論功行賞』。
這類研究是 agent 能力持續變強的底層引擎。今天這一版日報裡好幾篇都在談 agent——程序記憶、技能演化、多輪協作,而 TRIAGE 補的是最底層的訓練訊號怎麼給得更準。對一般使用者,這些細節看起來很遠,但它們決定了你明年用到的 AI agent 會不會更少犯蠢、更懂得哪一步重要。當各家都在拚 agent 誰更能自己動手辦事,能不能把『功過算得準』這件苦工做好,往往就是拉開差距的地方。
歸剛點評|agent 要更會辦事,底層得先把『哪一步該記功、哪一步該記過』算準。TRIAGE 把 GRPO 那種整組一致的粗獎勵,改成按動作角色論功行賞。這類訓練訊號的細活,決定了明年你用到的 AI agent 會不會更少犯蠢——是拉開各家差距的關鍵苦工。